ai-gpu
企业做 RAG 知识库需要哪些云服务?一套适合华为云部署的架构思路
企业做 RAG 知识库时,通常要同时考虑模型、向量数据库、文档存储、计算、网络和运维。本文按华为云部署场景梳理选型思路。
企业做 RAG 知识库,先要搞清楚云服务边界
企业想做 RAG 知识库,关心的通常不是“用哪个模型”这么简单。真正落地时,要把文档上传、切分、向量化、检索、模型问答、权限控制和日志运维都串起来。放到华为云部署场景里,常见基础组合会涉及华为云 ECS、华为云 OBS、数据库、GPU 或 AI 推理资源,以及对外访问所需的网络和安全服务。
RAG 的核心思路并不复杂:先把企业文档变成可检索的知识,再让大模型基于检索结果回答问题。难点在工程侧。文档从哪里来,向量存在哪里,模型跑在什么资源上,员工怎么访问,数据怎么隔离,这些问题如果一开始没想清楚,后面很容易返工。
一套 RAG 知识库通常由哪些模块组成?
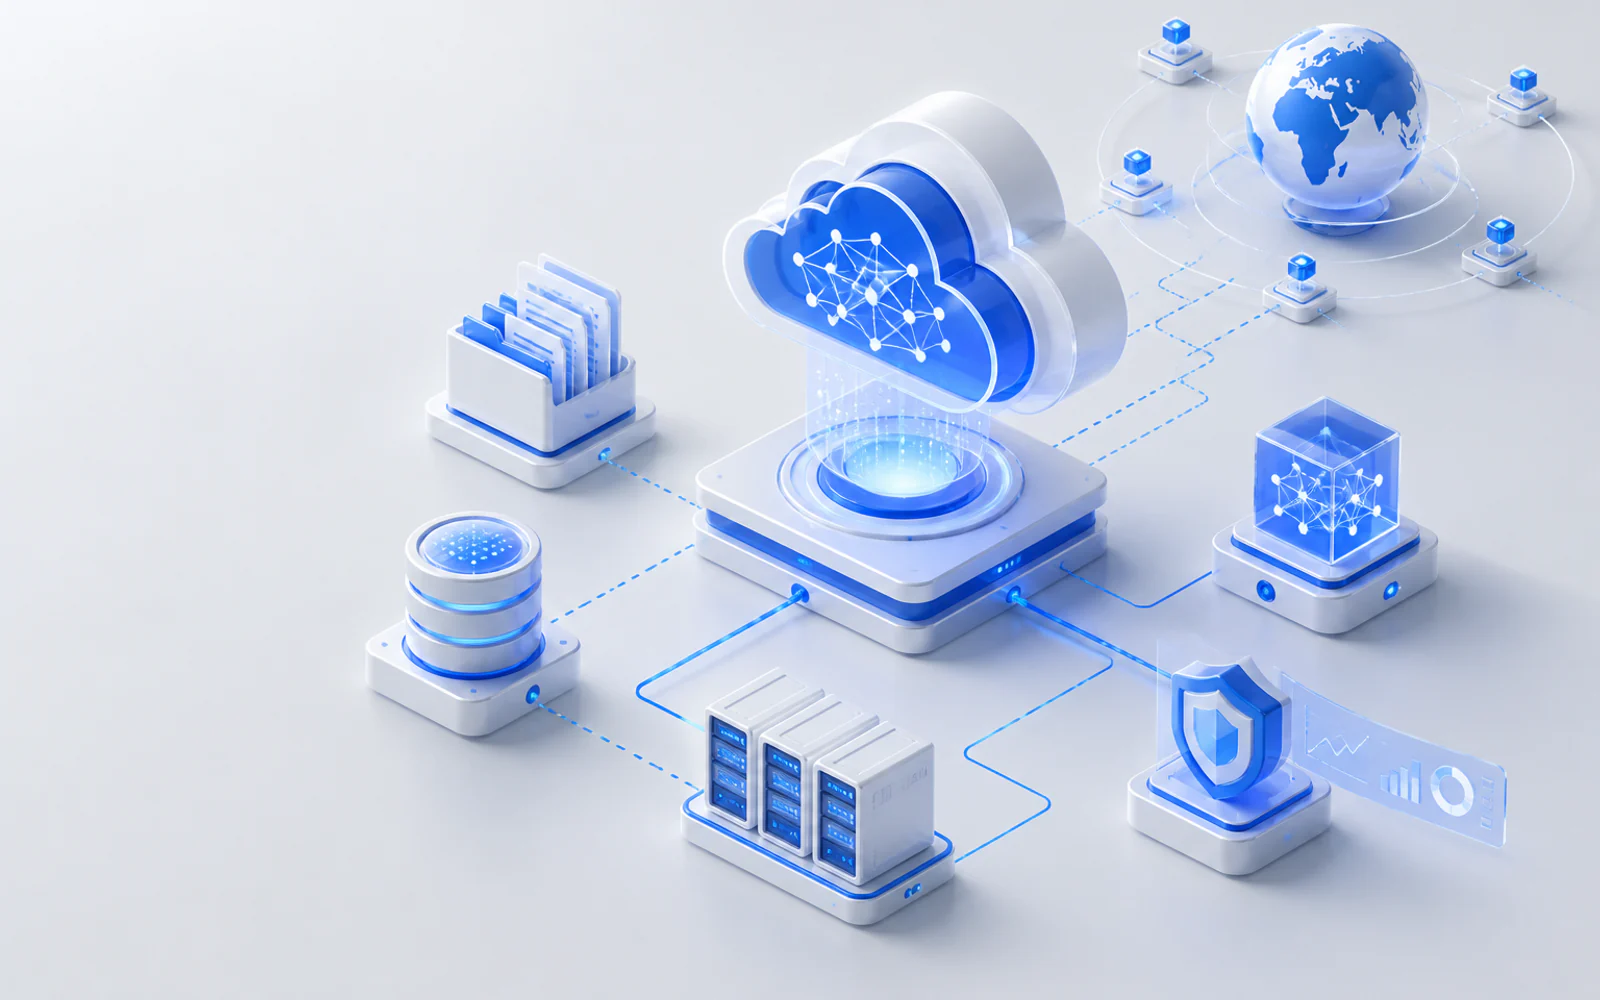
从企业部署角度看,RAG 知识库可以拆成六层:入口层、文档存储层、索引处理层、向量检索层、模型推理层、运维安全层。每一层都对应不同云服务,不建议把所有东西混在一台机器里长期运行。
入口层负责给员工或业务系统访问。可以是 Web 后台、内部 API,也可以接入现有办公系统。这里通常会用到华为云 ECS 承载应用服务。如果访问量来自多个地区,或有静态页面、附件下载等需求,再考虑华为云 CDN 做内容分发。CDN 更适合加速静态资源,不等于能直接加速模型推理。
文档存储层适合放原始文件、解析后的文本、图片和中间结果。华为云 OBS 更适合这类对象数据。企业常见的 PDF、Word、表格、网页归档文件,都可以先进入对象存储,再由后端任务进行解析和切分。这样做的好处是文件和计算解耦,后面换模型、重建索引也更方便。
索引处理层负责把文档清洗、分段、去重,再调用 embedding 模型生成向量。这部分对 CPU、内存和任务队列有要求。如果只是小规模知识库,可以先用 ECS 跑处理任务;如果文档量增长,建议把解析任务、向量生成任务和在线问答服务拆开,避免后台批处理影响用户问答体验。
华为云 ECS 在 RAG 架构里适合承担什么?
华为云 ECS 更适合作为应用服务、任务调度和轻量推理的承载层。比如知识库后台、权限系统、文件解析服务、API 网关后的业务服务,都可以部署在 ECS 上。企业刚开始验证 RAG 时,也常用 ECS 跑一套最小可用环境。
如果你只是做内部知识问答,文档规模不大,访问人数有限,可以先用 ECS 部署应用、检索服务和管理后台。模型部分可以接入外部模型服务,也可以使用云上 AI 相关能力,具体取决于数据合规、预算和响应速度要求。
如果你要私有化部署大模型,或者要跑 embedding、rerank、推理服务,就要评估 GPU 资源。GPU 选型不能只看模型名称,还要看参数规模、上下文长度、并发量、响应时间和是否需要多模型同时运行。涉及具体规格、可用区域和计费方式时,应以华为云官方最新说明和实际咨询为准。
华为云 OBS 为什么适合作为知识库文件底座?
RAG 知识库里的原始资料不能只放在应用服务器本地磁盘。应用升级、扩容、迁移时,本地文件会变成负担。华为云 OBS 更适合保存非结构化文件,也方便后续做生命周期管理、权限隔离和批量处理。
一个更稳妥的做法是:原始文件进入 OBS,解析后的文本和切分结果也保留一份,向量数据库只保存向量、片段 ID 和必要的元数据。用户提问时,系统先从向量库找相关片段,再回查文本内容,最后交给模型组织回答。
这样设计还有一个好处:当企业更换 embedding 模型或调整切分策略时,不需要重新上传全部资料。只要基于 OBS 中保留的原始文件或清洗文本重新建索引即可。
向量数据库怎么选?不要只看“能不能存向量”
向量数据库是 RAG 的检索核心,但选型不能只看功能名称。企业更应该看三件事:数据规模、检索延迟、运维方式。
小规模知识库可以从简单方案开始,比如在已有数据库能力上扩展向量检索,或自建开源向量库。这样上线快,便于验证业务价值。等到文档量、并发量、权限维度变多,再评估托管数据库、搜索服务或独立向量数据库方案。具体产品兼容能力、插件支持和版本限制,需要以官方文档为准。
权限也是很多企业容易忽略的点。RAG 不是把所有文档放进一个索引就结束了。不同部门、项目、岗位能看的资料不同,向量检索时也要带上权限过滤条件。否则模型可能从用户无权访问的片段里生成答案。
模型服务要怎么放进架构里?
RAG 至少会用到两类模型:embedding 模型和生成式大模型。有些场景还会加 rerank 模型,用来对检索结果重新排序。embedding 决定“能不能找准资料”,大模型决定“能不能讲清楚”。两者都重要。
如果企业对数据出域敏感,可以优先评估云上私有化或专属部署方案。这样架构会更重,需要考虑 GPU、镜像、模型加载、推理服务扩缩容和监控。如果对上线速度要求高,也可以先接入合规可用的模型服务做验证,再决定是否迁移到自部署方案。
在华为云部署时,建议把模型服务和业务应用解耦。业务系统只通过 API 调用模型,不要把提示词、检索、模型推理全部写死在一个服务里。后续换模型、调参数、加审核流程都会轻松很多。
华为云 CDN 在 RAG 项目里什么时候有用?
华为云 CDN 不是 RAG 的必选项,但在一些场景里有价值。比如知识库前端面向多地员工访问,页面静态资源较多,或者文档预览、图片加载频繁,可以用 CDN 改善静态资源访问体验。
但模型问答接口、检索接口通常涉及动态请求和权限判断,不能简单当作静态内容缓存。企业在设计访问链路时,要把“页面资源加速”和“后端问答处理”分开看。前者适合 CDN,后者更依赖 ECS、负载均衡、数据库和模型服务的整体设计。
企业落地 RAG 知识库时,建议按这几步走
1. 先列出知识来源。包括制度文档、产品手册、工单记录、FAQ、合同模板等,并标清哪些能进入知识库,哪些不能进入。 2. 设计文档处理流程。上传到 OBS 后,确定解析、切分、去重、版本管理和失败重试机制。 3. 选择向量检索方案。先按数据量和权限复杂度选一个可落地的方案,不要一开始就追求最重架构。 4. 明确模型部署方式。判断是接入模型服务,还是使用 GPU 资源自部署,并评估响应速度、数据边界和运维压力。 5. 部署应用和接口服务。用华为云 ECS 承载后台、API、任务服务,并做好日志、监控和访问控制。 6. 小范围试运行。用真实问题测试命中率、答案引用、拒答能力和权限隔离,再逐步扩展到更多部门。
这套流程不追求一步到位。RAG 项目最怕的是先堆资源,后面才发现文档质量差、权限没理清、答案不可追溯。先把闭环跑通,再扩容和优化,风险更低。
费用和风险主要看哪些因素?
RAG 知识库的成本通常来自计算、存储、数据库、网络流量和模型推理。华为云 ECS 的规格、OBS 存储量、GPU 使用方式、向量数据库方案、华为云 CDN 流量都会影响费用。具体价格、折扣和计费规则应以官方最新说明和实际咨询为准。
风险主要集中在三类:第一是数据权限,检索结果必须和用户权限绑定;第二是答案可信度,建议返回引用来源,方便员工核对;第三是运维复杂度,模型、索引、数据库和应用服务要分层监控,不能只看服务器是否在线。
如果你的企业准备做 RAG 知识库,可以先从文档范围、访问人群、模型部署方式和预算边界开始梳理。需要做华为云部署选型时,建议把 ECS、OBS、数据库、GPU 与 CDN 放在同一张架构图里评估,再决定哪些先上、哪些后补。
常见问题
需要进一步确认方案?
整理业务场景、访问地区、现有架构和上线时间,再评估合适的云服务组合。
预约咨询